dLLMs, SSMs & klassische LLMs – Was kommt nach ChatGPT?
Diffusion-LLMs, State Space Models, Mixture of Experts: Ein verständlicher Überblick über die nächste Generation von KI-Architekturen – und was sie für Unternehmen wirklich bedeuten.
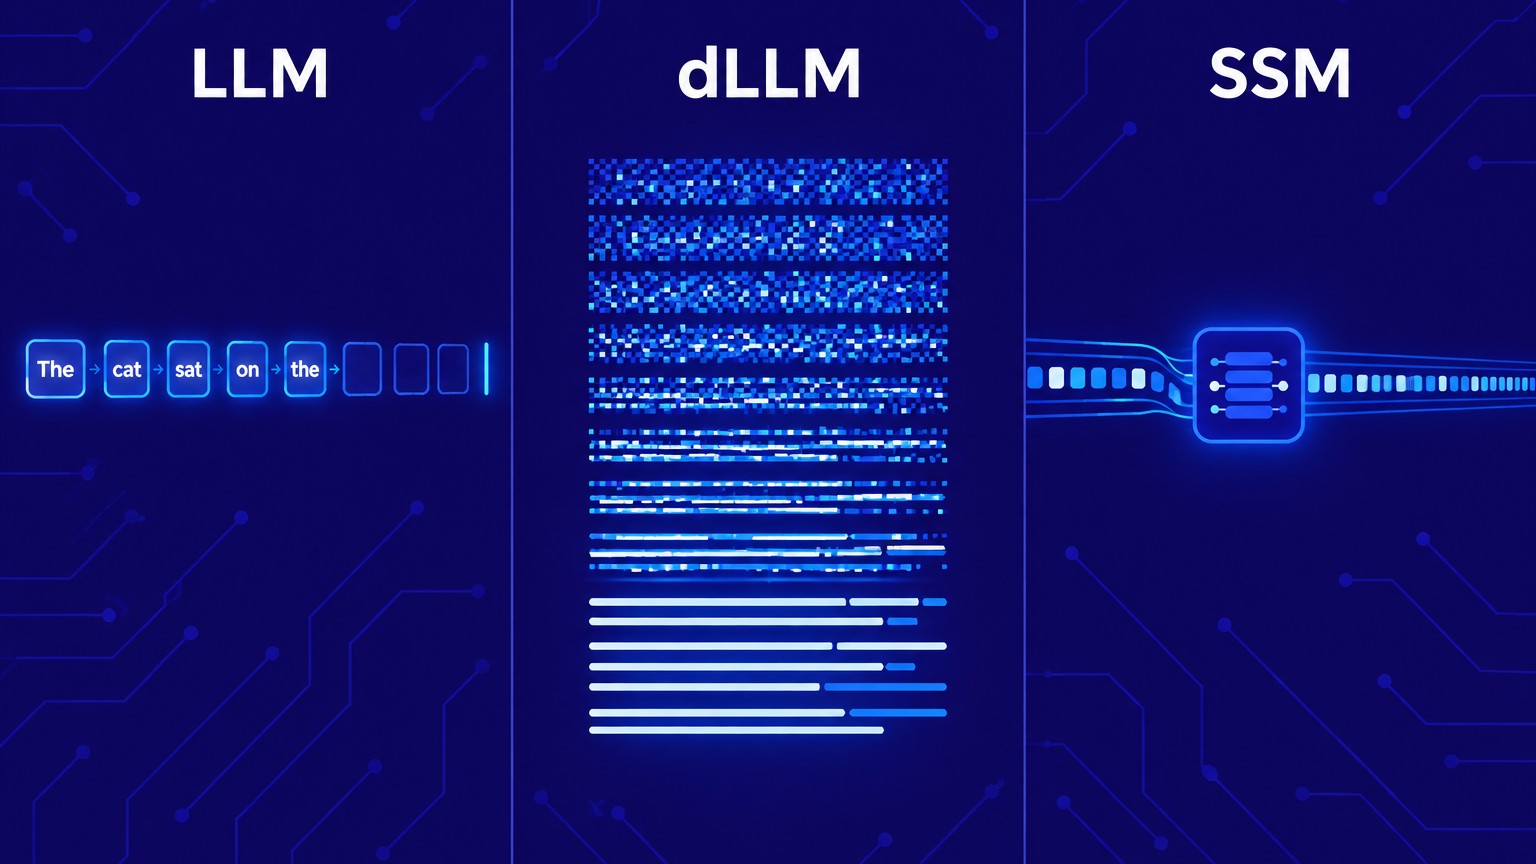
ChatGPT, Claude, Gemini – die meisten kennen mittlerweile zumindest einen dieser Namen. Was viele aber nicht wissen: Hinter all diesen Modellen steckt dieselbe Bauart, der autoregressive Transformer. Und genau dieser Standard bekommt 2026 zum ersten Mal ernsthafte Konkurrenz. In diesem Beitrag schauen wir uns die spannendsten neuen KI-Architekturen an – natürlich in klarer Sprache.
Wie klassische LLMs heute funktionieren
Ein klassisches LLM (Large Language Model) generiert Text Wort für Wort, von links nach rechts. Das Modell tippt sich quasi durch die Antwort – Token für Token. Diese sogenannten autoregressiven Modelle dominieren seit 2017 die KI-Welt: GPT, Claude, Llama, Mistral, DeepSeek – alle bauen auf der gleichen Transformer-Architektur auf.
Das Konzept hat sich bewährt, hat aber auch klare Schwächen:
- Langsam, je länger der Output wird
- Teuer im Betrieb bei großen Mengen
- Linear gedacht –> beim Schreiben jedes neuen Wortes, sieht das Modell nur, was davor steht.
Genau hier setzen die neuen Architekturen an.
dLLMs und SSMs
1. dLLMs – Diffusion Large Language Models
dLLMs übertragen das Prinzip der Bildgenerierung (Stable Diffusion, DALL·E) auf Text. Statt Wort für Wort zu schreiben, entrauschen sie den gesamten Text parallel – Schritt für Schritt, aber alles gleichzeitig.
Stärken:
- Bis zu 10× schneller als klassische LLMs
- Bessere globale Konsistenz, weil das gesamte Dokument im Blick bleibt
- Einfacheres Nachbearbeiten und Editieren mittendrin
Schwächen:
- Reasoning (Logik, Mathe, komplexe Code-Bugs) aktuell noch schwächer
- Tooling und Ökosystem stehen erst am Anfang
Bekannte Beispiele: Mercury (Inception Labs), LLaDA, DiffuLLaMA.
2. SSMs – State Space Models (Mamba & Co.)
State Space Models wie Mamba oder Jamba sind eine grundsätzlich andere Architektur. Sie skalieren linear mit der Textlänge – Transformer dagegen quadratisch. Heißt: Bei sehr langen Kontexten (z. B. 100.000 Tokens oder mehr) sind SSMs deutlich effizienter.
Stärken:
- Hervorragend bei sehr langen Texten und Dokumenten
- Sehr ressourcenschonend, auch lokal einsetzbar
Schwächen:
- Bei reinen Reasoning-Aufgaben aktuell noch hinter Transformern
- In der Praxis am stärksten als Hybrid (Transformer + Mamba)
3. Mixture of Experts (MoE)
Keine eigene Architektur, sondern eine clevere Ergänzung: Das Modell besteht aus vielen kleinen „Experten” – pro Anfrage werden aber nur wenige davon aktiviert. Ergebnis: Riesige Modelle bei vergleichsweise niedrigen Inferenzkosten. Mixtral, DeepSeek V3 und GPT-4 nutzen dieses Prinzip bereits.
4. Hybride Modelle
Der vermutlich interessanteste Trend: Architekturen, die Transformer + Mamba + teilweise Diffusion kombinieren. Jede Komponente übernimmt genau das, was sie am besten kann. Die ersten produktiven Modelle dieser Art gibt es bereits – und sie dürften die kommenden Jahre prägen.
Was bedeutet das für Unternehmen?
Spannende Forschung – aber was hat das konkret mit deinem Geschäft zu tun? Tatsächlich einiges.
- Geschwindigkeit wird zur Standard-Erwartung. KI-Funktionen, die heute noch 5 Sekunden brauchen, werden in 1–2 Jahren in Echtzeit antworten.
- KI-Hosting wird günstiger. Wer überlegt, KI-Modelle lokal oder auf eigenen Servern zu betreiben, bekommt mit dLLMs und SSMs deutlich kosteneffizientere Optionen.
- Lange Dokumente werden bezahlbar. Verträge, Reports, ganze Wissensdatenbanken lassen sich in Zukunft in einem Durchgang analysieren – ohne aufwändiges Aufsplitten.
- Edge-KI rückt näher. Modelle, die direkt auf Laptops, Tablets oder Smartphones laufen, werden realistisch.
Für kleine und mittlere Unternehmen heißt das: Was heute noch wie ein Spielzeug für Tech-Riesen aussieht, wird in absehbarer Zeit zu Werkzeugen, die sich auch im Alltag eines Handwerksbetriebs, einer Kanzlei oder eines Online-Shops einsetzen lassen.
Wer macht 2030 das Rennen?
Niemand weiß es. Wirklich. Realistischer als ein Sieger ist ein Mix:
- Klassische Transformer bleiben für komplexes Reasoning der Standard.
- dLLMs etablieren sich überall dort, wo Geschwindigkeit zählt (Code-Completion, Echtzeit-Chat, große Mengen an Standard-Outputs).
- SSMs werden zur Standardkomponente für lange Kontexte – meist als Hybrid mit Transformern.
Fazit
Die KI-Welt steckt mitten in einem Architekturwechsel – ähnlich wie 2017, als Transformer die damaligen Modelle (RNNs) ablösten. Für Unternehmen heißt das nicht, dass alles, was heute funktioniert, morgen veraltet ist. Es heißt aber: Wer KI ernsthaft im eigenen Betrieb einsetzt, sollte den Kopf nicht in den Sand stecken. Die Modelle, die wir in zwei Jahren produktiv nutzen, werden anders aussehen – schneller, günstiger und besser auf lange Inhalte ausgelegt.
Wir befinden uns in spannenden Zeiten.